IA en un minutoNoticiasModelos
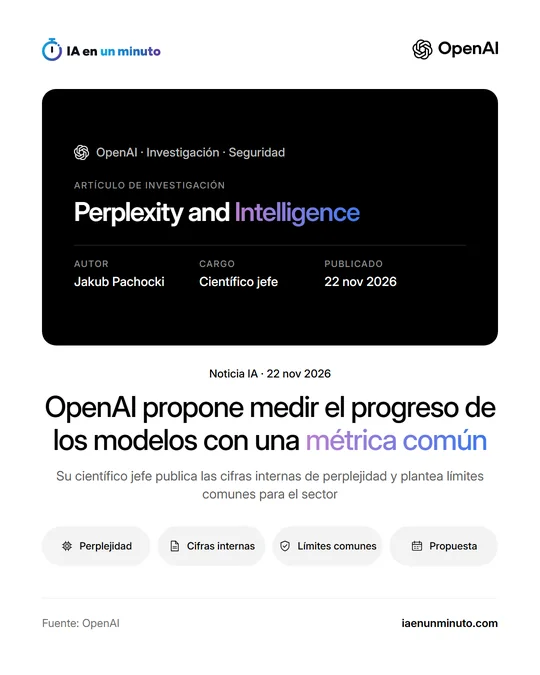
El científico jefe de OpenAI propone la perplejidad como métrica común para medir el progreso de los modelos de IA
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
Pachocki, científico jefe de OpenAI, quiere que la perplejidad sirva de vara de medir común entre laboratorios y de base para pactar normas de seguridad. OpenAI enseña sus cifras internas: GPT-3.5 ronda 0,99, GPT-4 ronda 0,91 y por debajo de 0,8 surgieron capacidades nuevas en ciberseguridad y matemáticas. Pachocki reconoce los fallos de la métrica y pide límites que nadie cruce sin un hito previo de supervisión.
El científico jefe de OpenAI, Jakub Pachocki, propone que los laboratorios usen la perplejidad (perplexity en inglés, que mide lo bien que un modelo predice el siguiente token, un fragmento de texto) como métrica común para comparar el progreso de los modelos de IA y fijar estándares de seguridad compartidos. Lo plantea en un artículo titulado «Perplexity and Intelligence», publicado en la web de OpenAI. Cuanto más baja es la perplejidad, mejor predice el modelo.
Como primer paso, OpenAI publica sus mediciones internas de pretraining (la fase de entrenamiento inicial sobre un gran corpus de datos). Con el logaritmo de la perplejidad sobre un conjunto de datos sacado de su código interno, GPT-3.5 está en torno a 0,99 y GPT-4 en torno a 0,91. OpenAI cuenta que, con valores por debajo de 0,8, han aparecido capacidades transformadoras en campos como la ciberseguridad y las matemáticas, y que con un modelo de unos 0,76 empezó a obtener resultados matemáticos de primer nivel ("groundbreaking" en el original) en problemas abiertos que la empresa lleva más de un año planteando a sus modelos. Pachocki reconoce que publicar estas cifras da a los competidores una imagen más clara de la posición de OpenAI, y sostiene que pesa más la urgencia de acordar medidas de seguridad compartidas.
El artículo mira también hacia delante. A partir del ritmo reciente, el autor espera nuevas capacidades transformadoras cuando los modelos entren en la franja de aproximadamente 0,68 a 0,70, y admite que no sabe cuáles serán ni si hoy se están evaluando. Añade que ya en 2027 podría verse una avalancha de avances fundamentales en pretraining si la propia IA participa en esa investigación, y considera improbable que el progreso en alineamiento y supervisión sea lo bastante rápido como para permitir toda esa aceleración.
Pachocki también plantea límites comunes para toda la industria, basados en la perplejidad y otras mediciones, que los desarrolladores se comprometan a no cruzar hasta que se logre un hito concreto de comprensión y supervisión del comportamiento de la IA. Como ejemplo de hito cita el desarrollo de un sucesor de los monitores de cadena de pensamiento (CoT, por sus siglas en inglés). Pide además que los desarrolladores de modelos de frontera acuerden normas para evaluar estos modelos y poner a prueba sus argumentos de seguridad antes de su primer uso, con estándares de transparencia compartidos.
Admite que la métrica tiene problemas: cada laboratorio usa datos distintos, no mide tareas concretas, no recoge los avances fuera del pretraining (el razonamiento en cadena de pensamiento no reduce la perplejidad aunque aumenta mucho las capacidades) y no se sabe cuál es su suelo, el valor mínimo que se puede alcanzar.
Es una propuesta de OpenAI, no un acuerdo del sector.
Por qué importa · análisis y opinión
Hasta ahora, los laboratorios comparaban sus modelos con pruebas de tareas concretas que, según el propio artículo, se quedan cortas en poco tiempo. La propuesta de Pachocki apunta a otra cosa: una cifra ligada al entrenamiento de base que serviría para decidir cuándo frenar. Que OpenAI enseñe sus números es un gesto que la propia empresa admite que le costó, pero la idea solo funciona si los demás laboratorios publican los suyos y aceptan medirlos de forma comparable, y nada de eso está pactado. Tampoco se dice quién vigilaría el cumplimiento de los límites ni qué pasaría si alguien los cruza. Para quien usa estos modelos en su trabajo no cambia nada hoy. Lo que sí deja el texto es un aviso de quien los fabrica: espera saltos de capacidad difíciles de prever y reconoce que las herramientas para supervisarlos van por detrás.
Fuente oficial: OpenAI · Redactada con ayuda de IA: cómo hacemos las noticias