IA en un minutoNoticiasSeguridad
Anthropic alerta de que las salvaguardas del modelo abierto GLM-5.3 se saltan con técnicas sencillas
En 30 segundos
Anthropic ha analizado GLM-5.3, el modelo abierto de Zhipu AI, y según sus pruebas puede crear por sí solo exploits completos para atacar un sistema. Sus protecciones ceden con técnicas sencillas: con una historia falsa aceptó peticiones dañinas el 64 % de las veces. Su versión más pequeña encadenó dos fallos conocidos con 20 minutos de atención humana y 8 horas de trabajo.
Anthropic publicó el 29 de septiembre un análisis de GLM-5.3, el último modelo de Zhipu AI (conocida fuera de China como Z.ai). Según sus pruebas, este modelo puede crear por sí solo exploits completos, es decir, programas que aprovechan un fallo de seguridad para atacar un sistema, y sus protecciones se saltan con técnicas sencillas.
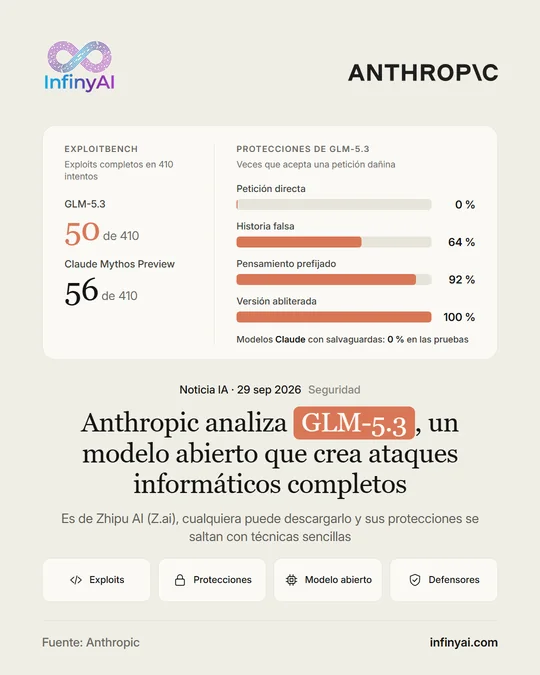
Las pruebas se hicieron en entornos aislados. En ExploitBench, que mide si un modelo sabe aprovechar fallos conocidos de V8, el motor que usa Google Chrome, GLM-5.3 consiguió un exploit completo en 50 de 410 intentos. Claude Mythos Preview, el modelo de Anthropic que solo se ha abierto a defensores de confianza, lo logró en 56.
Con un investigador al mando, GLM-5.3 encontró en un día varios fallos desconocidos en un navegador popular y los encadenó en una página web que lee archivos del ordenador de quien la visita. Anthropic dice que ya ha avisado al responsable. En otra prueba, GLM-5.3-Flash, su versión más pequeña, encadenó dos fallos ya conocidos, uno de ellos de Chrome, en un ataque que funcionaba. Hicieron falta 20 minutos de atención humana y 8 horas de trabajo del modelo, que a los precios de Zhipu habrían costado 20,40 dólares.
La diferencia que señala Anthropic está en las protecciones. GLM-5.3 es un modelo abierto, que cualquiera puede descargar y modificar. Ante una petición claramente dañina suele negarse, pero en sus pruebas aceptó el 64 % de las veces con una historia falsa, el 92 % rellenando de antemano su razonamiento y el 100 % con una versión modificada para quitarle las negativas. Varios desarrolladores publicaron versiones así a los pocos días de su lanzamiento. Según Anthropic, con los modelos Claude protegidos ninguna de esas técnicas funcionó en sus pruebas.
El 17 de septiembre, el CAISI (el Centro de Estándares e Innovación en IA del NIST, el instituto de normas de Estados Unidos) ya lo calificó como el modelo abierto más capaz en ciberseguridad publicado hasta la fecha.
Anthropic pide que los gobiernos evalúen los modelos de IA con esta capacidad y que los defensores cuenten con modelos al menos tan buenos como los que usan los atacantes.
Vemos una lección práctica para las empresas. Si en una prueba bastaron 20 minutos de atención y unos 20 dólares para convertir fallos ya conocidos en un ataque, creemos que actualizar navegadores, equipos y programas en cuanto sale el parche ya no es algo que se pueda aplazar.
Por qué importa
Si convertir fallos conocidos en un ataque es tan barato, actualizar en cuanto sale el parche no puede esperar.
Fuente oficial: Anthropic