IA en un minutoNoticiasModelos
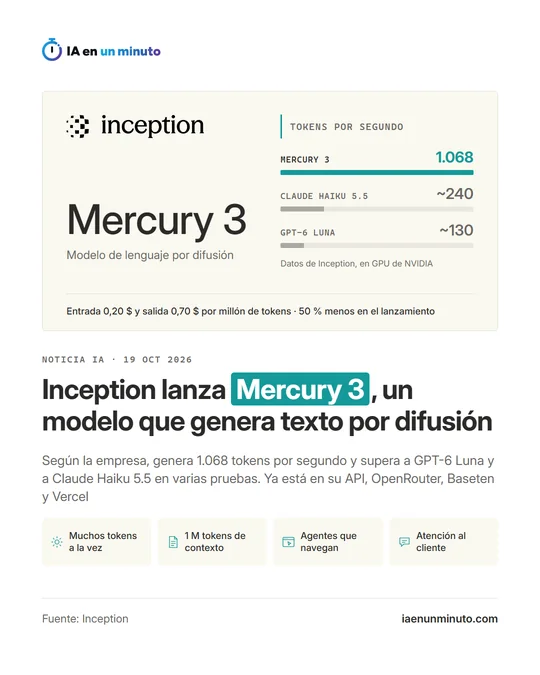
Inception presenta Mercury 3, un modelo de lenguaje por difusión que genera 1.068 tokens por segundo
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
Inception ha lanzado Mercury 3, que no avanza fragmento a fragmento como otros modelos de lenguaje, sino que saca muchos tokens de golpe gracias a la difusión. La empresa dice que alcanza 1.068 tokens por segundo y que deja atrás en velocidad y en varias pruebas a GPT-6 Luna y Claude Haiku 5.5. Mercury 3 admite un contexto de un millón de tokens y se puede usar ya en OpenRouter, Baseten, Vercel y la API de la propia empresa.
La empresa Inception presentó el lunes 19 de octubre Mercury 3, su nuevo modelo de lenguaje basado en difusión. Como explica en su web, el resto de modelos escribe el texto token a token (los fragmentos de texto que procesa el modelo), mientras que los de difusión generan muchos tokens a la vez. La empresa lo describe como el modelo de difusión más capaz publicado hasta ahora.
Inception asegura que Mercury 3 genera 1.068 tokens por segundo en GPU de NVIDIA, entre cuatro y ocho veces más rápido que GPT-6 Luna, de OpenAI, y Claude Haiku 5.5, de Anthropic, y que los supera en varias pruebas. En la tabla de resultados del anuncio, GPT-6 Luna aparece con aproximadamente 130 tokens por segundo y Claude Haiku 5.5, con aproximadamente 240.
Es más de 40 veces más grande que Mercury 1, su primer modelo, y puede trabajar con un millón de tokens de contexto (el texto que tiene en cuenta de una vez), frente a los 260.000 de Mercury 2.5.
Ya se puede usar en la API de Inception (la conexión para desarrolladores) y a través de OpenRouter, Baseten y Vercel, y es compatible con la API de OpenAI. Cuesta 0,20 dólares por cada millón de tokens de entrada y 0,70 dólares por cada millón de salida, aunque durante el lanzamiento tiene un 50 % de descuento, con 0,10 y 0,35 dólares. Los tokens en caché cuestan un 90 % menos que los de entrada.
Según Inception, las empresas que lo han probado antes del lanzamiento ya lo usan en atención al cliente por voz y por chat, tutorías en tiempo real, ingeniería de datos y navegación web. Las cifras de velocidad y de las pruebas las da la propia Inception.
Por qué importa · análisis y opinión
Lo novedoso no es solo la velocidad, sino que una técnica distinta a la habitual empiece a medirse de tú a tú con los modelos rápidos de OpenAI y Anthropic. Si se confirma, quien construye asistentes de voz, chats de atención al cliente o agentes que navegan por la web tendría una opción más para recortar la espera. Falta, eso sí, que alguien ajeno a Inception repita sus mediciones: las cifras de velocidad y de calidad son de la propia empresa y dependen de qué tareas se comparen. Para un equipo técnico, lo sensato es probarlo con sus propias peticiones, ya que se conecta igual que la API de OpenAI y cambiar de modelo cuesta poco, y comparar latencia, aciertos y coste antes de llevarlo a producción.
Fuente oficial: Inception · Redactada con ayuda de IA: cómo hacemos las noticias