IA en un minutoNoticiasEmpresas y producto
OpenAI cuenta cómo ha hecho crecer el almacenamiento que sirve a más de 1.000 millones de usuarios de ChatGPT
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
Habitat, el sistema donde OpenAI guarda los datos de ChatGPT, la API y Codex, funciona sobre Azure Cosmos DB y supera ya los 500 petabytes. La empresa relata dos caídas de finales de 2024 que la llevaron a vigilar la plataforma junto a los ingenieros de Azure. Con el servicio reescrito en Rust y una caché, la lectura típica ronda ahora los 10 milisegundos.
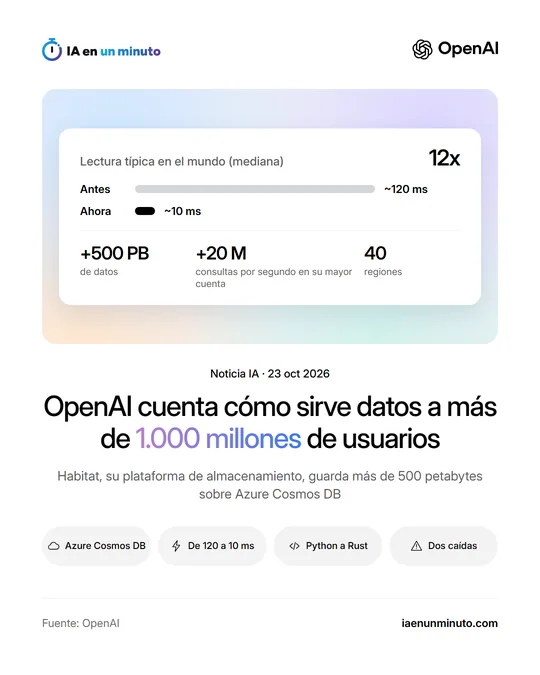
OpenAI ha publicado en su blog de ingeniería la segunda parte de una serie sobre Habitat, la plataforma de almacenamiento en línea de la que dependen muchos de sus productos, entre ellos ChatGPT, la API y Codex, además de servicios internos. Según la empresa, Habitat tiene que contestar en milisegundos a más de 1.000 millones de usuarios repartidos en 40 regiones geográficas y ya sirve más de 500 petabytes de datos. La primera parte, publicada el 11 de septiembre, contaba cómo pasó de una biblioteca en Python a un servicio.
Esta segunda entrega se centra en la capa de abajo: Azure Cosmos DB, la base de datos en la nube de Microsoft. La mayor cuenta de OpenAI en Cosmos DB guarda decenas de petabytes y atiende más de 20 millones de consultas por segundo, y la empresa afirma que, hasta donde sabe, ninguna otra compañía ha desplegado Cosmos DB con ese tamaño. El texto describe un recorrido en tres fases: primero, un único contenedor compartido en cada cuenta; después, contenedores separados para cada servicio o función grande; y al final, la vuelta a contenedores compartidos por defecto, con la posibilidad de mover datos entre ellos. El equipo de Cosmos DB creó para OpenAI un modo serverless mejorado que les permitió dejar de vigilar y ampliar los contenedores a mano. Desde entonces, según OpenAI, no han tenido incidentes de aprovisionamiento ni de «vecinos ruidosos», cargas que acaparan los recursos compartidos.
La entrada también relata dos caídas. A finales de 2024, un corte de luz en la región principal de Azure de una de sus mayores cuentas de Cosmos DB dejó ver que trasladar las cuentas más grandes a una región secundaria llevaría varias horas, algo que ni OpenAI ni el equipo de Cosmos DB habían probado a ese tamaño. Alrededor de un mes después, al devolverlas a la región original, provocaron otra caída grave. Hoy los equipos de Habitat y de Azure vigilan juntos todas las capas, desde los servicios de OpenAI hasta el almacenamiento físico de Cosmos DB.
Más del 90 % de las peticiones a Habitat son lecturas, y acelerarlas ha sido una prioridad este año. Para ello guardan los datos cerca de los usuarios cuando la capacidad lo permite, usan una caché y han reescrito en Rust el servicio, que antes estaba en Python. Con todo ello, la mediana del tiempo de lectura en todo el mundo ha bajado de aproximadamente 120 milisegundos a aproximadamente 10, una mejora de 12 veces desde que empezaron a centrarse en el rendimiento a principios de año. Las peticiones más lentas todavía tienen que ir a buscar datos que no están en la caché, a menudo en regiones lejanas.
Para los próximos 1.000 millones de usuarios, OpenAI explica que está desarrollando un sistema de almacenamiento propio a escala de exabytes, pensado para los datos más voluminosos de Habitat, que une el núcleo RocksDB Cloud de Rockset con replicación basada en Raft.
Por qué importa · análisis y opinión
La lección que sirve fuera de OpenAI es que un servicio gestionado deja de serlo del todo cuando el uso crece mucho: llega un punto en que proveedor y cliente tienen que compartir pruebas, paneles y responsabilidad sobre los fallos. Las dos caídas que relata la entrada nacen de algo que nadie había ensayado, mover cuentas enormes de una región a otra, y eso vale para cualquier empresa con un plan de recuperación que nunca ha puesto a prueba. El sistema propio que OpenAI ya está construyendo indica, además, que ni esa colaboración cubrirá sola el siguiente salto. Para equipos pequeños, lo práctico es ensayar de verdad el cambio de región, medir dónde se va el tiempo de cada petición y solo después decidir si hace falta reescribir algo.
Fuente oficial: OpenAI · Redactada con ayuda de IA: cómo hacemos las noticias