IA en un minutoNoticiasEmpresas y producto
Microsoft presenta Maia 300, su tercer chip propio de IA, y hará de Maia su sistema principal de inferencia
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
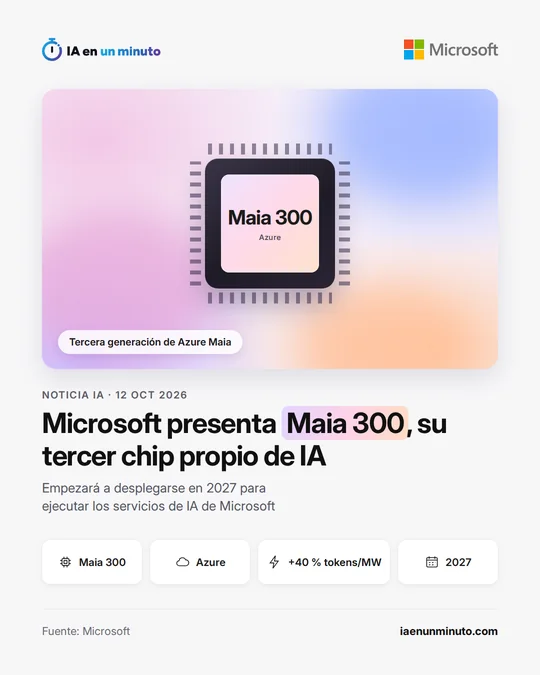
Microsoft va a convertir Maia, sus chips de diseño propio, en la plataforma principal de inferencia de sus servicios, con un despliegue de varios gigavatios desde 2027. Maia 300, la tercera generación, entrará en producción ese año y la compañía prevé que cada megavatio rinda en tokens un 40 % más que en los sistemas líderes con GPU. La anterior, Maia 200, ya atiende a Microsoft Copilot y dará servicio a GitHub Copilot antes de acabar el año.
Microsoft ha anunciado que Maia, su familia de chips propios de IA, será el "sistema principal de inferencia" (el que ejecuta los modelos ya entrenados) de sus productos y servicios. Para ello ampliará su despliegue a partir de 2027, hasta instalaciones de varios gigavatios. También ha presentado Maia 300, la tercera generación de la familia, que empezará a desplegarse en producción ese mismo año.
Según Scott Guthrie, vicepresidente ejecutivo de nube e IA de Microsoft, que firma el anuncio, la empresa espera que Maia 300 dé un 40 % más de tokens (las unidades de texto que procesa la IA) por megavatio que los principales sistemas basados en GPU. En su configuración completa, con 96 aceleradores en un mismo armario de servidores, alcanza hasta 7 veces el caudal de tokens de un armario de Maia 200. Está diseñado para razonar con contextos largos, para conversaciones en las que cuenta la rapidez de la respuesta y para tareas de agentes de varios pasos.
La generación anterior, Maia 200, se anunció en enero y ya funciona en servicios como Microsoft Copilot, el asistente de IA de la compañía. Llegará a GitHub Copilot, el asistente de programación, y a Microsoft Foundry antes de fin de año. Se está desplegando en Estados Unidos, Europa y Australia, y ejecuta modelos de OpenAI, los modelos MAI de la propia Microsoft y familias de modelos de código abierto. Microsoft le atribuye hasta 1,7 veces más tokens por vatio que la principal infraestructura de GPU en las funciones de IA integradas en Teams, Copilot y Cowork.
En lo técnico, Maia 300 reparte el trabajo entre varios chiplets (piezas de silicio separadas para el cálculo, el control de la memoria y las entradas y salidas), y los de cálculo se fabrican con el proceso N2P de TSMC. Cada acelerador lleva ocho pilas de memoria HBM4 dentro de una potencia térmica de diseño de 950 vatios; un armario completo se mantiene dentro de 167 kilovatios. Según la descripción técnica publicada por Azure, eso supone 2,5 veces el ancho de banda de memoria de Maia 200 y un 33 % más de capacidad.
El anuncio no da precios, no dice en qué regiones se instalará Maia 300 y no nombra a los fabricantes de las GPU con las que se compara. The Verge, que recoge el anuncio, lo presenta como un chip que hace a Microsoft menos dependiente de las GPU de Nvidia. Microsoft adelanta que dará más información sobre su estrategia el mes que viene en Ignite 2026, su conferencia en San Francisco.
Por qué importa · análisis y opinión
La noticia de fondo no es el chip, sino el cambio de papel. Hasta ahora los procesadores propios de Microsoft convivían con las GPU como una pieza más de su infraestructura; el anuncio los coloca en el centro de la ejecución de sus modelos. La razón está en la unidad que elige para medirse: tokens por megavatio. Cuando lo que limita un centro de datos es la potencia eléctrica y la refrigeración, quien saca más respuestas de la misma energía puede atender a más usuarios sin construir más. Para una empresa que usa Copilot o contrata modelos en Azure no cambia nada de un día para otro: el despliegue grande empieza el año que viene y Microsoft no habla de precios. Falta también una comparación con nombres y medida por terceros, porque las cifras son previsiones del propio fabricante frente a rivales que no identifica.
Fuente oficial: Microsoft · Redactada con ayuda de IA: cómo hacemos las noticias