IA en un minutoNoticiasModelos
NVIDIA lanza Nemotron 3.5 Super VL, un modelo abierto y multimodal para agentes
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
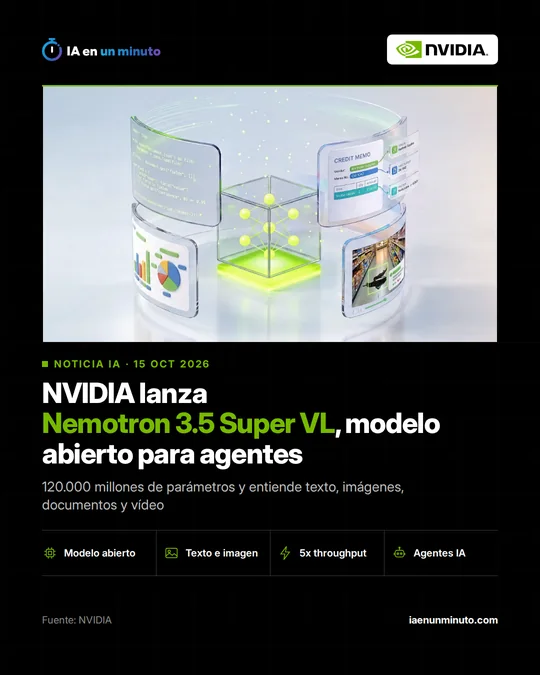
NVIDIA ha presentado un modelo de pesos abiertos para agentes de empresa, Nemotron 3.5 Super VL, capaz de leer texto, imágenes, documentos y vídeo. De sus 120.000 millones de parámetros solo usa 12.000 millones por token, y la compañía asegura que en una GPU rinde hasta 5 veces más que rivales abiertos de su tamaño. Scale AI, Ramp y AI21 ya lo están adaptando a tareas propias.
NVIDIA presentó el jueves 15 de octubre, en su blog para desarrolladores, Nemotron 3.5 Super VL: un modelo abierto y personalizable pensado para agentes de empresa que manejan a la vez texto, imágenes, documentos y vídeo.
Usa una arquitectura de mezcla de expertos (MoE): tiene 120.000 millones de parámetros, pero en cada token solo trabajan 12.000 millones. NVIDIA asegura que, en una sola GPU, consigue hasta 5 veces más throughput (capacidad de procesamiento) en tareas de agentes que otros modelos abiertos de su categoría; según su gráfico, supera los 600 tokens por segundo en el índice de Artificial Analysis con el servicio de Baseten. El modelo se ha destilado de Nemotron 3 Ultra, el mayor de la familia, y en las pruebas de agentes Hermes Bench y LangChain lo supera: 63,44 % frente a 56,33 % y 87,05 % frente a 84,3 %.
La idea es que un solo modelo razone, siga instrucciones y llame a herramientas sin que haga falta montar por separado uno de texto y otro de visión, ni pasarse el contexto entre ellos. Su entrenamiento visual abarca gráficos, tablas, reconocimiento de texto (OCR), documentos de varias páginas y vídeo. En CharXiv, una prueba de lectura de gráficos, obtiene un 80,8 %, cuando Nemotron 3 Nano Omni se quedaba en el 63 %.
Cada empresa puede posentrenarlo con sus datos, herramientas y normas mediante NVIDIA NeMo, las bibliotecas abiertas de la compañía. Con el modelo, NVIDIA publica en Hugging Face conjuntos de datos abiertos (entre ellos, 40 de visión y lenguaje) y versiones base, posentrenada y cuantizada en 4 bits (NVFP4), con sus recetas de entrenamiento. Los pesos se pueden instalar en equipos propios, en centros de datos o en la nube, y el modelo también se ofrece alojado en OpenRouter y como microservicio NVIDIA NIM. El anuncio no menciona precios.
Entre los primeros clientes, Scale AI lo ha ajustado para tramitar abonos de proveedores en la productora Skydance y prevé que el coste de inferencia de esa tarea baje 40 veces; Ramp lo usa para convertir fotos de recibos en datos estructurados, y AI21 y Alice lo han adaptado al análisis de amenazas y vulnerabilidades, con un 41 % más de precisión. Según The Decoder, NVIDIA estrenó al mismo tiempo dos modelos más pequeños para equipos locales, Nemotron 3.5 Bolt 74B-A9B y Bolt E4B (este, más adelante en octubre), y en el índice general de Artificial Analysis Super VL queda muy por detrás de los mejores modelos cerrados.
Por qué importa · análisis y opinión
La apuesta de NVIDIA no es competir con los modelos cerrados más potentes, de los que este queda lejos, sino con el coste de tener agentes trabajando sin parar. Para quien ya procesa facturas, contratos o recibos, juntar visión y texto en un solo modelo simplifica la arquitectura y reduce los saltos donde un agente pierde el contexto. Que los pesos y buena parte de los datos de entrenamiento sean abiertos permite ajustarlo con información sensible sin sacarla de casa, algo que pesa en banca o ciberseguridad. Falta saber cuánto rinde fuera del escaparate: casi todas las cifras las da NVIDIA, medidas en su propio hardware, y parte de los casos de clientes son previsiones. Antes de cambiar de modelo, conviene probarlo con documentos propios.
Fuente oficial: NVIDIA · Redactada con ayuda de IA: cómo hacemos las noticias