IA en un minutoNoticiasEmpresas y producto
Meta borra de sus términos comerciales la frase que, según expertos, le permitía entrenar su IA con contenidos web
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
Meta ha quitado la palabra entrenar del permiso que se reserva para rastrear las webs ligadas a sus cuentas comerciales, entre ellas las de casi todos los medios. Nieman Lab y varios expertos veían en esa frase una vía para usar gratis ese material con su IA, algo que Meta niega: según la empresa, el rastreo solo sirve a la publicidad y a sus servicios para empresas. El cambio llega antes del 30 de octubre, cuando entran en vigor.
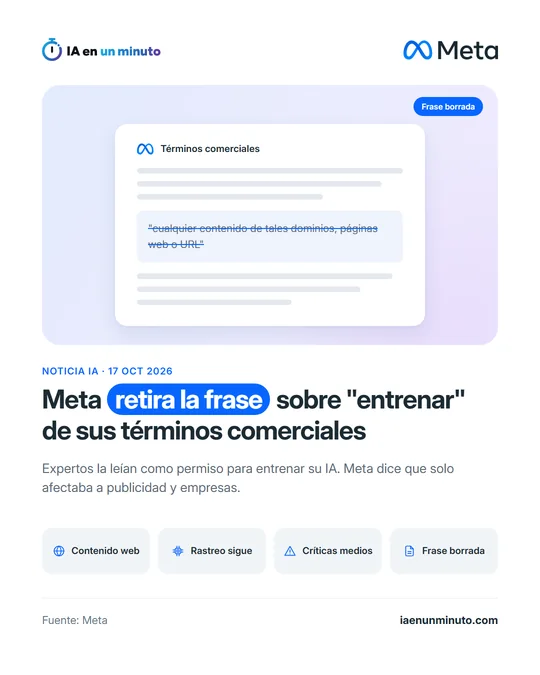
Meta ha quitado de sus nuevos términos comerciales una frase que, según varios expertos, le permitía entrenar su IA con el contenido de las webs que rastrea. El cambio lo publicó The Verge el sábado 17 de octubre. Meta sostiene que esos términos solo afectaban a sus productos de publicidad y para empresas.
La frase decía que Meta podía usar "cualquier contenido de tales dominios, páginas web o URL" para "proporcionar, desarrollar, mejorar, investigar, entrenar y mantener la integridad" de sus productos. Según Nieman Lab, alcanzaba a las webs asociadas a las cuentas comerciales de Facebook, Instagram o WhatsApp, y casi todos los medios de comunicación tienen al menos una. Nieman Lab y James Grimmelmann, profesor de derecho digital e información en Cornell, lo interpretaron como un intento de dar a Meta el derecho a entrenar gratis su IA con el contenido de esos sitios y de saltarse las instrucciones de bloqueo del archivo robots.txt, el que dice a los rastreadores qué pueden leer.
Meta avisó de la actualización a principios de octubre. Según Nieman Lab, las cuentas comerciales no tenían forma de quedar fuera antes de que se aplique: el texto pide a quien no esté de acuerdo que deje de usar los productos de Meta con fines comerciales. En un primer momento, Andy Stone, vicepresidente de comunicación de Meta, y el portavoz Daniel Roberts rechazaron esa lectura y aseguraron que no había "ningún cambio" en cómo usa Meta los rastreadores web.
Tras las críticas, Meta ha cambiado el texto. La nueva versión mantiene el permiso para rastrear esas webs, incluida la posibilidad de crear credenciales de prueba para acceder a ellas, pero ya no habla de entrenar y liga el rastreo a sus productos de publicidad y para empresas. En una declaración posterior a The Verge, Roberts dijo que esto "no cambia cómo usa Meta los rastreadores web", que "no se trata de rastrear webs de noticias" y que los dueños de las webs pueden seguir indicando sus preferencias con robots.txt.
La frase estaba en la versión de los términos que entra en vigor el 30 de octubre, así que nunca llegó a aplicarse.
Por qué importa · análisis y opinión
El episodio enseña dónde se juega hoy el acceso de la IA al contenido ajeno: en la letra pequeña de unas condiciones que se aceptan para poder anunciarse o gestionar una página. Que bastara una frase para que expertos en derecho vieran un permiso de entrenamiento, y que la presión pública la hiciera desaparecer antes de aplicarse, dice mucho de lo frágil que es ese terreno. La retirada no cierra la puerta al rastreo, que sigue en el texto, así que cualquier empresa o medio con cuenta comercial en Meta hará bien en leer la versión nueva antes de que se aplique y en revisar qué permite su robots.txt. También conviene guardar una copia de lo que se acepta: este caso muestra que el texto puede cambiar entre el anuncio y la fecha de entrada en vigor.
Fuente: The Verge · Redactada con ayuda de IA: cómo hacemos las noticias