IA en un minutoNoticiasModelos
Liquid AI lanza LFM3, una familia de seis modelos abiertos para audio y uso multimodal en local
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
Liquid AI ha publicado seis modelos abiertos que trabajan con audio, texto, imágenes y vídeo y se pueden ejecutar en un equipo propio. El de texto, pensado para agentes locales, ocupa aproximadamente 1 GB al comprimirse a 4 bits, según la empresa. La familia incluye uno de voz que traduce en 18 idiomas y uno omni que entiende todos los formatos y responde con voz.
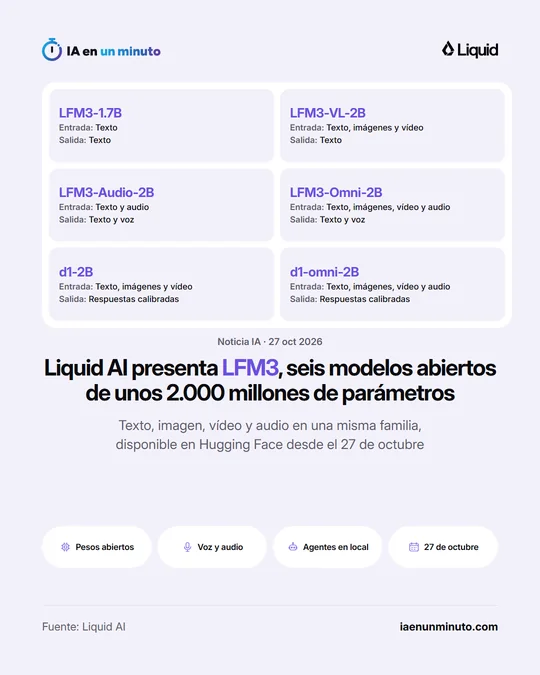
Liquid AI, la empresa que desarrolla modelos de IA pensados para funcionar en cualquier dispositivo, ha presentado LFM3, una familia de seis modelos de pesos abiertos, es decir, que se pueden descargar y ejecutar en un equipo propio. Los publicó el 27 de octubre en Hugging Face, la plataforma donde se comparten modelos, y, según su entrada en el blog, cada uno se puede ajustar con datos propios en una sola GPU.
Los seis rondan los 2.000 millones de parámetros, los valores internos que un modelo ajusta al entrenarse, y salen de la misma base de texto, LFM3-1.7B-Base. LFM3-1.7B, el modelo de texto, está pensado para agentes locales, es decir, programas de IA que encadenan pasos y usan herramientas en el propio equipo. Según Liquid AI, supera a su antecesor LFM2.5-2.6B con un 35 % menos de parámetros, cabe en unos 1 GB con precisión de 4 bits y tiene una ventana de contexto, el texto que puede tener presente a la vez, de 256.000 tokens, fragmentos de palabra.
LFM3-Audio-2B recibe texto o voz y responde con texto, con voz o con ambos. Sirve para chatear por voz, reconocer y sintetizar voz y traducir en 18 idiomas. Frente a LFM2.5-Audio-1.5B, su modelo de audio anterior, la empresa dice que habla con más calidad y que añade comprensión de audio y llamadas a herramientas.
LFM3-Omni-2B es el primer modelo omni de Liquid AI: entiende texto, imágenes, vídeo y audio y responde con texto y voz. LFM3-VL-2B es el primero de sus modelos de visión que acepta vídeo.
La familia se completa con d1-2B, que trabaja con texto, imágenes y vídeo, y d1-omni-2B, que añade el audio. A estos dos se les da una situación, como una incidencia de un cliente, y una lista de preguntas, y responden a todas de una vez, cada una con su probabilidad. Todas las cifras y comparaciones son de las pruebas de la propia empresa.
Por qué importa · análisis y opinión
Que los modelos sean abiertos y pequeños desplaza parte del trabajo de voz e imagen desde servicios en la nube hacia la máquina del propio usuario. Para una pyme o un profesional con datos delicados, como llamadas de clientes o grabaciones de reuniones, transcribir o traducir en local evita enviar el audio a un tercero. A cambio, hace falta alguien que instale y mantenga el modelo, y todas las comparaciones proceden de pruebas de la propia Liquid AI, sin verificación externa. Quien ya paga por transcribir o atender por voz puede probar el modelo de audio con sus propias grabaciones y comparar el resultado con el de su proveedor actual antes de decidir si le compensa el cambio.
Fuente oficial: Liquid AI · Redactada con ayuda de IA: cómo hacemos las noticias