IA en un minutoNoticiasRegulación
Wikimedia pide al tribunal del caso contra OpenAI y Microsoft que los chatbots no reproduzcan textos sin licencia
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
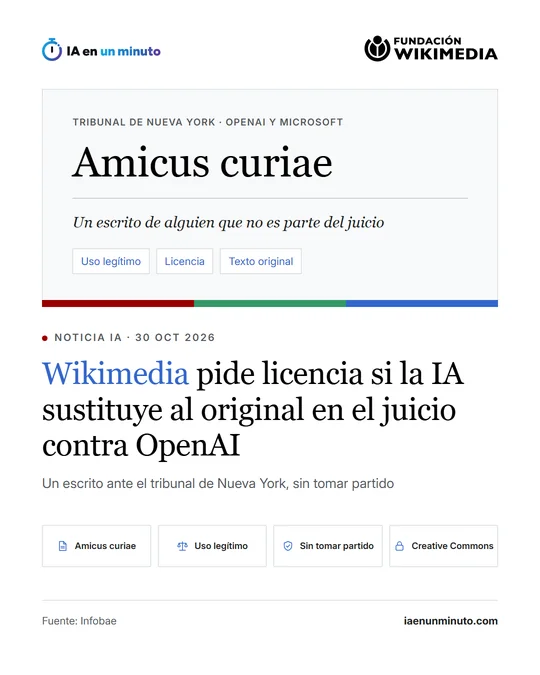
Wikimedia, la fundación que está detrás de Wikipedia, ha enviado un escrito al tribunal de Nueva York que juzga a OpenAI y Microsoft por entrenar IA con noticias, sin apoyar a ninguna parte. Wikimedia defiende que entrenar modelos pueda ser uso legítimo si aporta algo distinto, pero reclama una licencia si un chatbot extrae un texto y sustituye la lectura del original. Sidney Stein, juez del caso, evalúa las peticiones de sentencia sumaria.
La Fundación Wikimedia, que gestiona Wikipedia, ha entrado en el litigio de The New York Times contra OpenAI y Microsoft sin tomar partido. Según Infobae, ha presentado en el tribunal de Nueva York un amicus curiae, un documento con el que quien no es parte del proceso da su opinión razonada al juez, en la causa sobre el empleo de noticias para entrenar IA.
Wikimedia advierte, según The Verge citado por Infobae, de que las posturas de ambos bandos conducen a aplicar el uso legítimo de forma «excesiva y simplificada». Se trata de la figura que, en determinados supuestos, permite servirse de obras protegidas sin autorización. La fundación plantea un término medio: rastrear datos de webs no sería una infracción, y entrenar un modelo con obras protegidas sin licencia sería legítimo si el resultado aporta «algo nuevo y diferente». Ahora bien, exige licencia si un chatbot recupera un texto y lo ofrece de modo que la gente ya no necesita leer el original. También acusa a servicios como ChatGPT de difundir textos de la enciclopedia incumpliendo su licencia libre Creative Commons, que obliga a citar la fuente y a publicar cualquier adaptación bajo la misma licencia.
La causa ha recibido más intervenciones. Según Infobae, en septiembre el Gobierno de Estados Unidos presentó un escrito favorable a OpenAI; esta semana han entrado la Asociación de Editores Estadounidenses, que se alinea con los demandantes, y el profesor Matthew Sag, que se mantiene neutral. Sidney Stein, el juez, examina las peticiones cruzadas de sentencia sumaria. Según Sag, lo que decida sería el primer pronunciamiento del Segundo Circuito sobre si es uso legítimo entrenar modelos con libros y artículos, y el primero en el mundo sobre las reclamaciones de editoriales de noticias.
Por qué importa · análisis y opinión
Esta intervención no pesa por ser una de las partes, sino por quién la firma: una organización que vive de contenido abierto y que se queja de cómo se reutiliza. Su propuesta separa dos usos que suelen mezclarse: aprender de los textos, que ve aceptable, y servir su contenido como respuesta, que obliga a cumplir una licencia. Para una empresa que publique contenidos con licencia abierta, o que use chatbots para generar textos, la diferencia importa: reproducir fragmentos sin citar la fuente podría ser un problema aunque el modelo se haya entrenado de forma legal. Queda por ver si el juez acoge esa distinción en su decisión y qué harían con ella otros tribunales.
Fuente: Infobae · Redactada con ayuda de IA: cómo hacemos las noticias