IA en un minutoNoticiasRegulación
Google, OpenAI, Anthropic y Microsoft planean respetar una señal común en robots.txt para no entrenar su IA con una web
Redacción de IA en un minuto · Editor: Jon Elgezabal
En 30 segundos
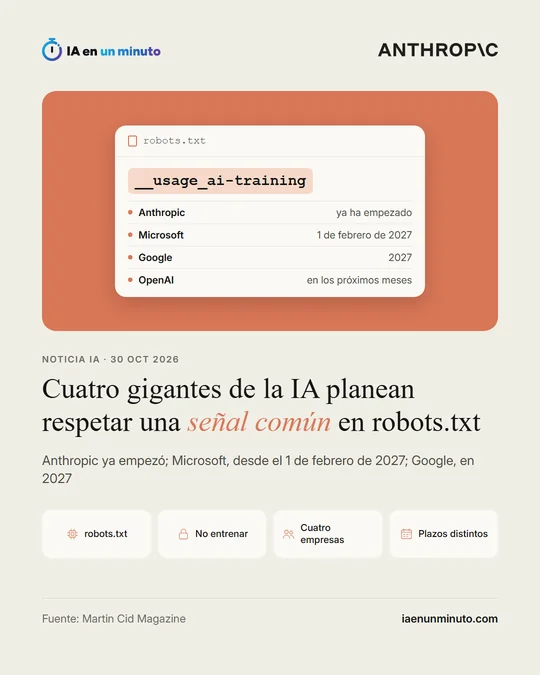
Anthropic, Google, OpenAI y Microsoft planean aceptar una misma línea de robots.txt con la que una web excluya su contenido del entrenamiento de IA. Kevin Kelley, de Anthropic, la propuso ante el IETF; Anthropic ya ha empezado a aplicarla, Google prevé unirse en 2027 y Microsoft, el 1 de febrero de 2027. Meta no ha aclarado si se sumará.
Una sola línea en robots.txt (el archivo de texto que indica a los buscadores adónde no deben entrar) serviría para pedir que no se entrene IA con el contenido de una web, si las empresas cumplen lo que han anunciado. Kevin Kelley, de Anthropic, presentó el 30 de octubre ante el IETF, el organismo que redacta las normas técnicas de internet, un borrador para su grupo de trabajo sobre preferencias de IA. Según la prensa especializada que recoge Martin Cid Magazine, Google, OpenAI y Microsoft planean respetarlo.
Hasta ahora, quien quería negarse tenía que redactar una norma por empresa, citando rastreadores como GPTBot, ClaudeBot o Google-Extended. El borrador evita crear una gramática nueva: dentro de un grupo de reglas convencional, donde normalmente iría el nombre de un bot, se escribe el identificador __usage_ai-training. Con «Disallow: /» el sitio manifiesta que no quiere ningún entrenamiento y con «Allow» deja pasar rutas concretas, por ejemplo un dossier de prensa. Hay dos salvedades. El comodín «User-agent: *» queda fuera de esta señal, así que un archivo que hoy veta a todos los robots no manifiesta preferencia alguna sobre el entrenamiento. Y el identificador no gobierna el rastreo: solo trata de cómo se usan los contenidos.
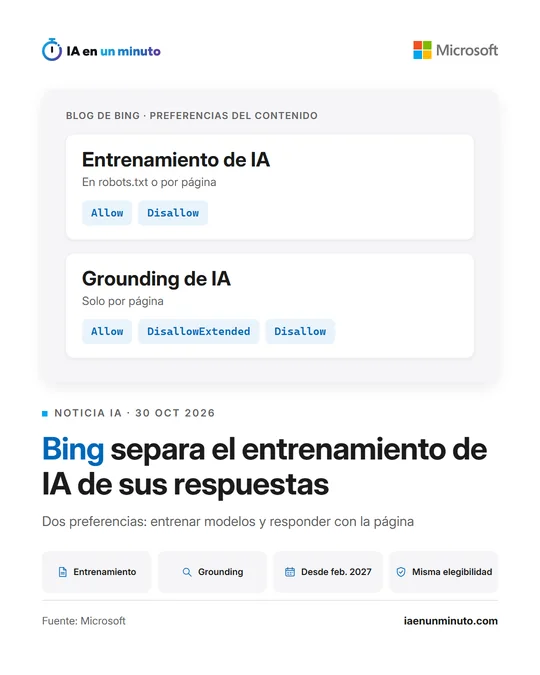
Los plazos varían. Anthropic ha empezado a incorporarlo, aunque Kelley escribió que extenderlo a todos sus servicios requerirá tiempo. Microsoft solo lo atenderá en los rastreos hechos después del 1 de febrero de 2027; a partir del 1 de marzo, sus etiquetas NoArchive y NoCache dejarán de contar como avisos de entrenamiento o de fundamentación. Esa fundamentación es una preferencia independiente, que se configura en cada página, y Microsoft advierte de que rechazarla restará visibilidad al sitio en sus respuestas de IA de forma notable. Google espera admitir el identificador durante 2027 y, ante un sitio que lo use sin citar Google-Extended, actuará como si se hubiera bloqueado Google-Extended. OpenAI promete sumarse en los próximos meses. Meta no ha dicho si lo atenderá; su responsable de comunicación, Andy Stone, calificó de «un paso importante» una señal común en declaraciones a The Verge, recogidas por Martin Cid Magazine.
Según Google y Microsoft, la señal no impide aparecer en sus resultados de búsqueda. Tampoco deshace lo que ya se rastreó, y el borrador aún debe pasar por el grupo de trabajo del IETF antes de convertirse en norma, de modo que no obliga a ninguna empresa a respetarlo.
Por qué importa · análisis y opinión
Para quien administra una web, lo relevante es que la petición deja de exigir aprenderse el nombre de cada rastreador. Pero sigue siendo una petición: ninguna empresa está obligada y el borrador necesita pasar por el IETF. La trampa práctica está en el comodín, porque un robots.txt actual que bloquea a todos los bots no dice nada sobre esta señal; quien quiera excluirse tendrá que añadir el grupo nuevo y revisar antes qué reglas tiene ya para Google-Extended, ya que Google solo aplica la señal si el sitio no lo menciona. También cuenta la diferencia entre entrenamiento y fundamentación: negar la segunda puede costar visibilidad en las respuestas de IA de Microsoft. La ausencia de Meta recuerda que el alcance dependerá de quién se sume, y que lo ya rastreado queda fuera de la señal.
Fuente: Martin Cid Magazine · Redactada con ayuda de IA: cómo hacemos las noticias